一個不會講話的 AI
你的 agent 每做一件事,背後其實問了大模型好幾個小問題,像是這個連結能不能點、這個指令會不會刪掉檔…
背景
2026 年 9 月 15 日,TypeSafe AI 發表 Jev
一個不會講話的 AI
你叫 agent 做事的時候,它其實一路都在問大模型小問題。這封信的連結能不能點,這個指令會不會刪掉檔案,這件事該交給哪個模型。每問一次,都要等大模型想好幾秒再打一段字回來。
創辦人 Diogo Almeida 在 OpenAI 時參與過讓 ChatGPT 學會聽指令的研究。他的新模型 Jev 反過來做,只回答選項和機率,一個字都不寫。
它怎麼運作
你出題目,它直接圈答案
把問題變成選擇題
你先把問題寫成選擇題、打分數或是非題,例如「這封信是釣魚信的機率多高」。Jev 把所有題目同時答完,官方說 一次 0.07 到 0.5 秒,而且只收你送進去的字,回答不收錢。官方還讓它即時玩 Doom,一秒問十次。
TypeSafe 說它的幻覺率是 0%,因為答案只能從你給的選項挑。但他們在同一篇文章裡寫明 這個數字不是實測的。它不會亂編,還是可能選錯。
官方數字
宣傳的倍數,是跟誰比出來的
- 193.6 倍
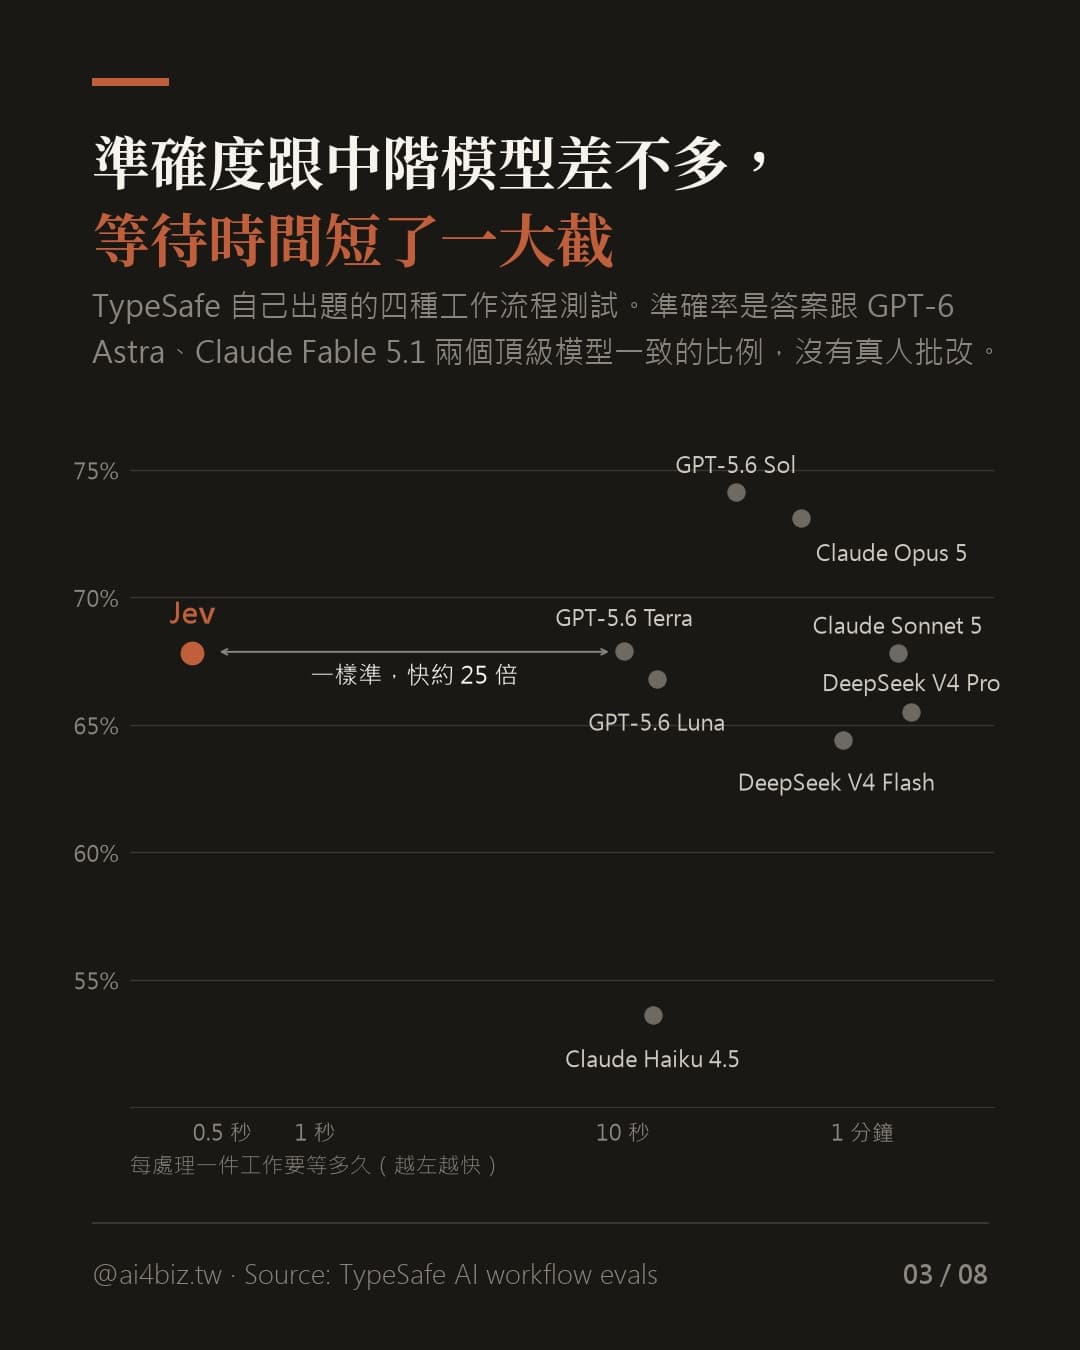
- 官網寫的「快幾倍」,比的是表上 最慢的 Claude Sonnet 5,一件工作要 78 秒
- 444.6 倍
- 官網寫的「便宜幾倍」,比的是最貴的 Claude Opus 5,TypeSafe 自己也說這是上限
- 25 倍
- 對手換成跟它一樣準的 GPT-5.6 Terra,快的倍數就剩這麼多,成本則是 便宜約 76 倍
- 0 人
- 參與出標準答案的真人。答案是 GPT-6 Astra 和 Claude Fable 5.1 兩個模型給的
別人自己測
讓 agent 判斷信裡的連結能不能點
- 62.6%
- 一位開發者(GitHub 帳號 anisselbd)拿 2,000 封信測,Jev 答對的比例。Claude Haiku 4.5 是 81.3%
- 43%
- 真正的釣魚信裡,Jev 只認出四成多,一半以上被它放過
- 約 3 倍
- 速度比 Haiku 快,成本便宜約 12 倍,一千封信花不到 4 美分
- 95.1%
- 作者把 Jev 順便回答的五個小問題重新組合,例如連結是不是放在免費網站,準確率就追上 Haiku
另一份測試
另一位開發者 themsquared 在 GitHub 出的 60 題
它沒把握的時候,會老實說
這份題目是判斷 agent 準備執行的指令危不危險,例如會不會刪資料、會不會把資料往外傳。Jev 答對 55 題,每題不到 0.6 秒。
答錯的那 5 題,它給的把握都偏低,沒有一題是說很有把握卻答錯。所以可以讓它先處理有把握的,沒把握的再交給大模型或人。
不過 60 題很少,作者也說別過度解讀。前一頁的釣魚信測試裡,它給的把握反而比 Haiku 不準。
帶走這句
它不是更聰明的 AI,是更便宜的直覺。
如果你的 agent 每天要做幾千次小判斷,要不要點、該交給誰、這筆算哪一類,Jev 這種模型能把每次判斷的等待和花費壓到幾乎感覺不到。
但它的準確度還是中階模型的水準,高風險的關卡別讓它自己守。比較實際的用法是讓它先篩一輪,沒把握的再往上交。
官方數字都是自己出題自己考的,拿來用之前,先用你自己的題目測一輪。
出處
這些都可以自己查
「25 倍、76 倍」是用官方比較表自行換算的。兩份第三方測試都是個人開發者公開的程式,任何人都能重跑,但不是研究機構做的正式評測。
發表文、價格、Doom 示範與 0% 幻覺的說明
TypeSafe AI 官方部落格 · Introducing System One Models & Jev · 2026/9/15
準確率、成本與耗時比較表
evals.typesafe.ai · 四種工作流程,標準答案由 GPT-6 Astra 與 Claude Fable 5.1 產生
釣魚信測試,2,000 封
GitHub · anisselbd/jev-phishing-bench · 2026/9/17
agent 指令風險測試,60 題
GitHub · themsquared/jev-benchmark · 2026/9/17