大模型負責寫,Jev 只負責判
客人傳來一句「我聯絡你們三次了,到現在還在等」,你真正想知道的只有一件事,他是不是在不爽。
JEV 101
一次看懂 TypeSafe 的判斷模型
大模型負責**寫**, Jev 只負責**判**
ChatGPT、Claude 這些大模型,擅長的是把答案一個字一個字寫出來。
TypeSafe 在 9 月發表的 Jev 走另一條路。它不生成任何回覆,只針對你問的問題回傳機率,專門處理企業流程裡大量又細碎的判斷。
先看一個場景
你其實只想知道一件事
客人說「我聯絡你們三次了, 到現在還在等」
這時候你真正要的答案很短,就是這位客人是不是在不爽,好決定要不要先把他排到前面。
交給一般大模型,它會先寫出「您好,很抱歉讓您久等了」一整段回覆。字寫得越多,等待越久,帳單也越貴。
Jev 不寫字,把可能的答案攤開,每個答案的機率一次平行算完。
它要吃什麼
一個請求只要給兩樣東西
- State 狀態
- 要判斷的資料本身,純文字、JSON 物件或陣列都可以,例如那則客人訊息
- Questions 問題
- 你想問的題目,寫明題型,需要時再附選項或刻度。同一則訊息可以一次掛好幾題
- 回傳
- 每題用你取的名字對應回來,程式直接接著用,下一步怎麼做由你的程式決定
三種題型
是非、選擇、打分,看你要什麼答案
- 是非 Noul
- 問「這位客人聽起來不爽嗎」,回傳答「是」的機率。0.95 代表有 95% 偏向是(官方簡報範例值),接近 0 就是偏向否
- 選擇 Choice
- 從你給的選項裡挑,例如催進度、要退款、要換貨、其他。回傳選中的那個,附上每個選項的機率
- 打分 Score
- 問「有多不爽」,0 沒不滿、1 不滿意、2 很火大。分數是各級機率的加權平均,可以落在 1.5 這種兩級之間(官方簡報範例值)
該信多少
官方簡報自己先講了這句
格式正確的答案, **還是可能錯**
選擇題和打分題會附一個把握度,依機率分布得多集中算出來。把握度高過你設的門檻,程式自動處理;低於門檻,轉給真人看。
官方也提醒,把握度不等於準確率,門檻要先拿自己的資料測過再定。是非題沒有另外的把握度,直接看機率離 0.5 有多遠。
帶走這句
把 agent 每一步的小判斷,交給**便宜的直覺**。
你的 agent 或客服流程裡,每天有成千上萬個小決定,要不要轉真人、這筆算哪一類、這封信危不危險。
這些判斷不需要文筆,需要的是快和便宜。大模型留給真的要寫的地方,判斷交給 Jev 這類模型,再用門檻和真人把關。
出處
運作方式出自官方簡報
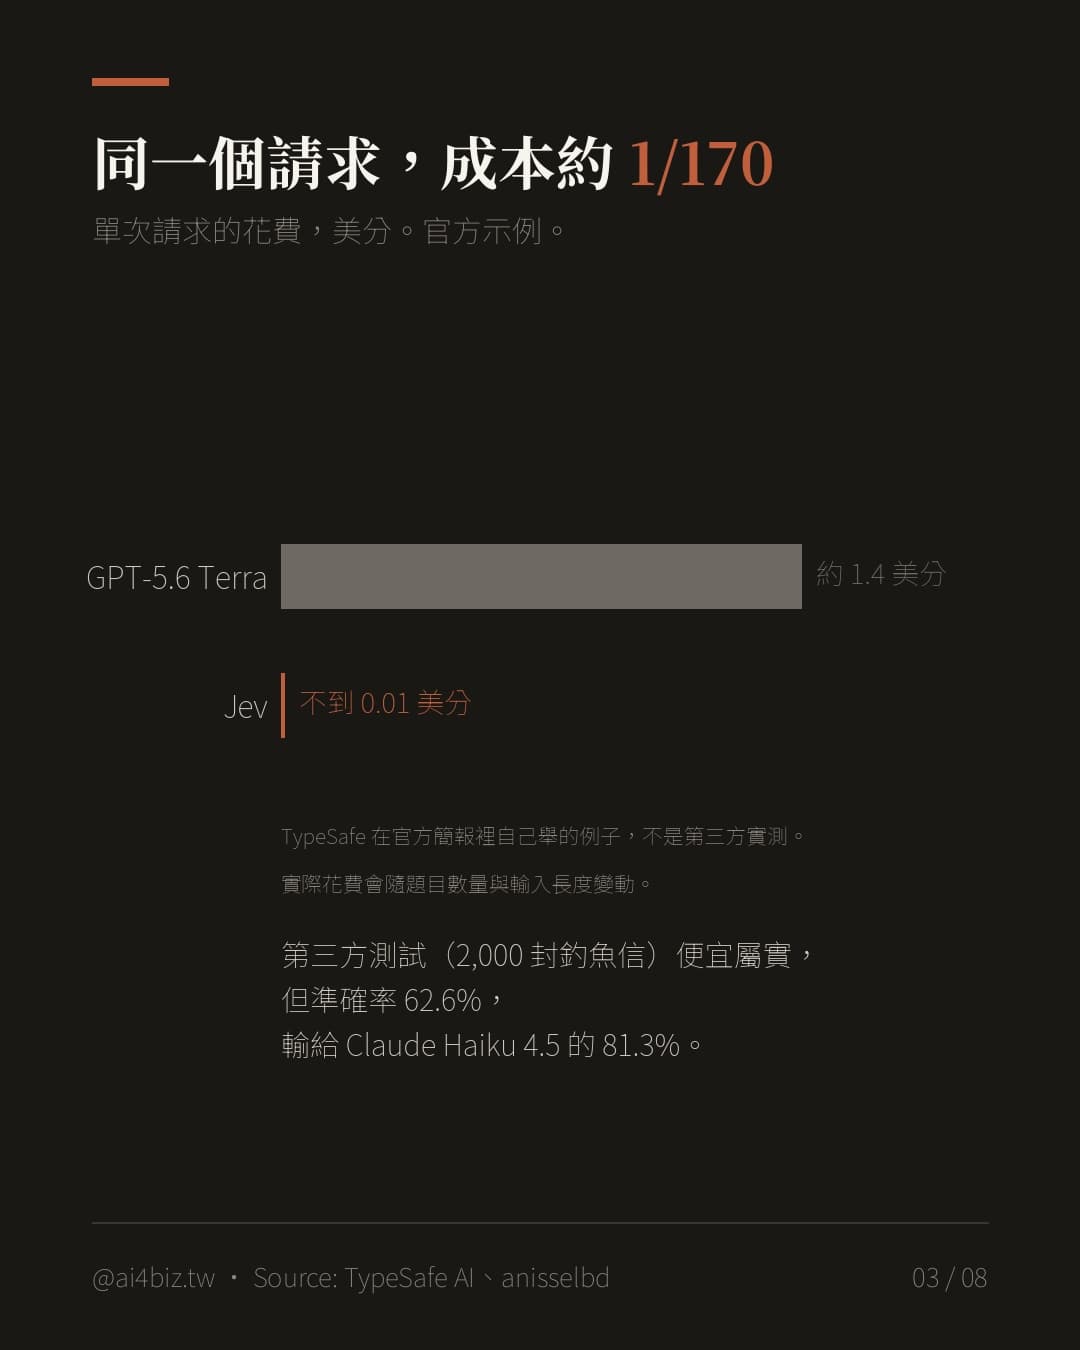
本篇非業配,ai4biz 與 TypeSafe 沒有合作關係。成本 1.4 美分對不到 0.01 美分是 TypeSafe 自舉示例。
題型、輸入輸出、把握度
TypeSafe AI 官方 Discord 簡報〈How is Jev different from other LLMs?〉· 2026/9/23
產品發表
TypeSafe AI 官方部落格〈Introducing System One Models & Jev〉· 2026/9/15
第三方測試
anisselbd/jev-phishing-bench(2,000 封釣魚信)· 2026/9/17;拆解見本頻道 Jev 圖卡〈一個不會講話的 AI〉